
核心问题: 14MB、2-bit 的模型能否达到你的工具调用与结构化抽取准确率门槛?
RepoDaily 采用评分
RepoDaily 将该项目的采用分评为 90/100(强):分数来自文章来源、安装路径、生产风险、差异化、许可证清晰度以及 AI/Agent 适配度。
包含 4 个来源、覆盖 4 类来源;如有 RepoDaily 独有模块,会进一步提高证据分。
检测到 7 个工作流步骤、5 个下一步动作,以及 3 个命令/安装信号。
趋势热度为 +661 stars;如内容中有 release、issue 或维护信号,会提高维护可信度。
采纳风险标记为 medium,并包含 5 条安全说明与 5 条跳过条件。
3 个机会视角、4 个替代方案,以及 4 个类型化模块支撑差异化判断。
文章中包含许可证来源或许可证表述。
文章正文和元数据中检测到 5 个 AI/Agent 相关信号。
项目概览
Needle 2 是 Cactus Compute 发布的 45M 参数开源模型,专注三件事:工具调用、设备操作和结构化抽取。整个模型以单个 14MB 二进制交付,权重直接烘焙在内;README 称一场完整会话约需 28MB 内存。团队用自家的 Cactus Quants 工具把它压到 CQ2-bit,并配上专属推理引擎,因此没有需要单独下载、版本化和管理的模型文件。
这个仓库就是 Python 包:推理、LoRA 微调和导出。安装只要一行 pip install cactus-needle,首次运行会从 Hugging Face 拉取一次推理引擎并缓存;README 明确说没有别的要编译,隔离设备的离线部署写在 doc/apis.md。权重也放在 huggingface.co/Cactus-Compute/needle2,供直接取用。
在项目公布的基准上,Needle 2 与 FunctionGemma 270M、LFM2.5 230M、Apple FM 互有胜负,而体积小 5 到 70 倍,用 2-bit 对阵它们的 f16。这些是厂商自报数字,当作起点而非结论;但尺寸差距本身就是卖点——这个量级的模型在 f16 下通常要几百 MB。
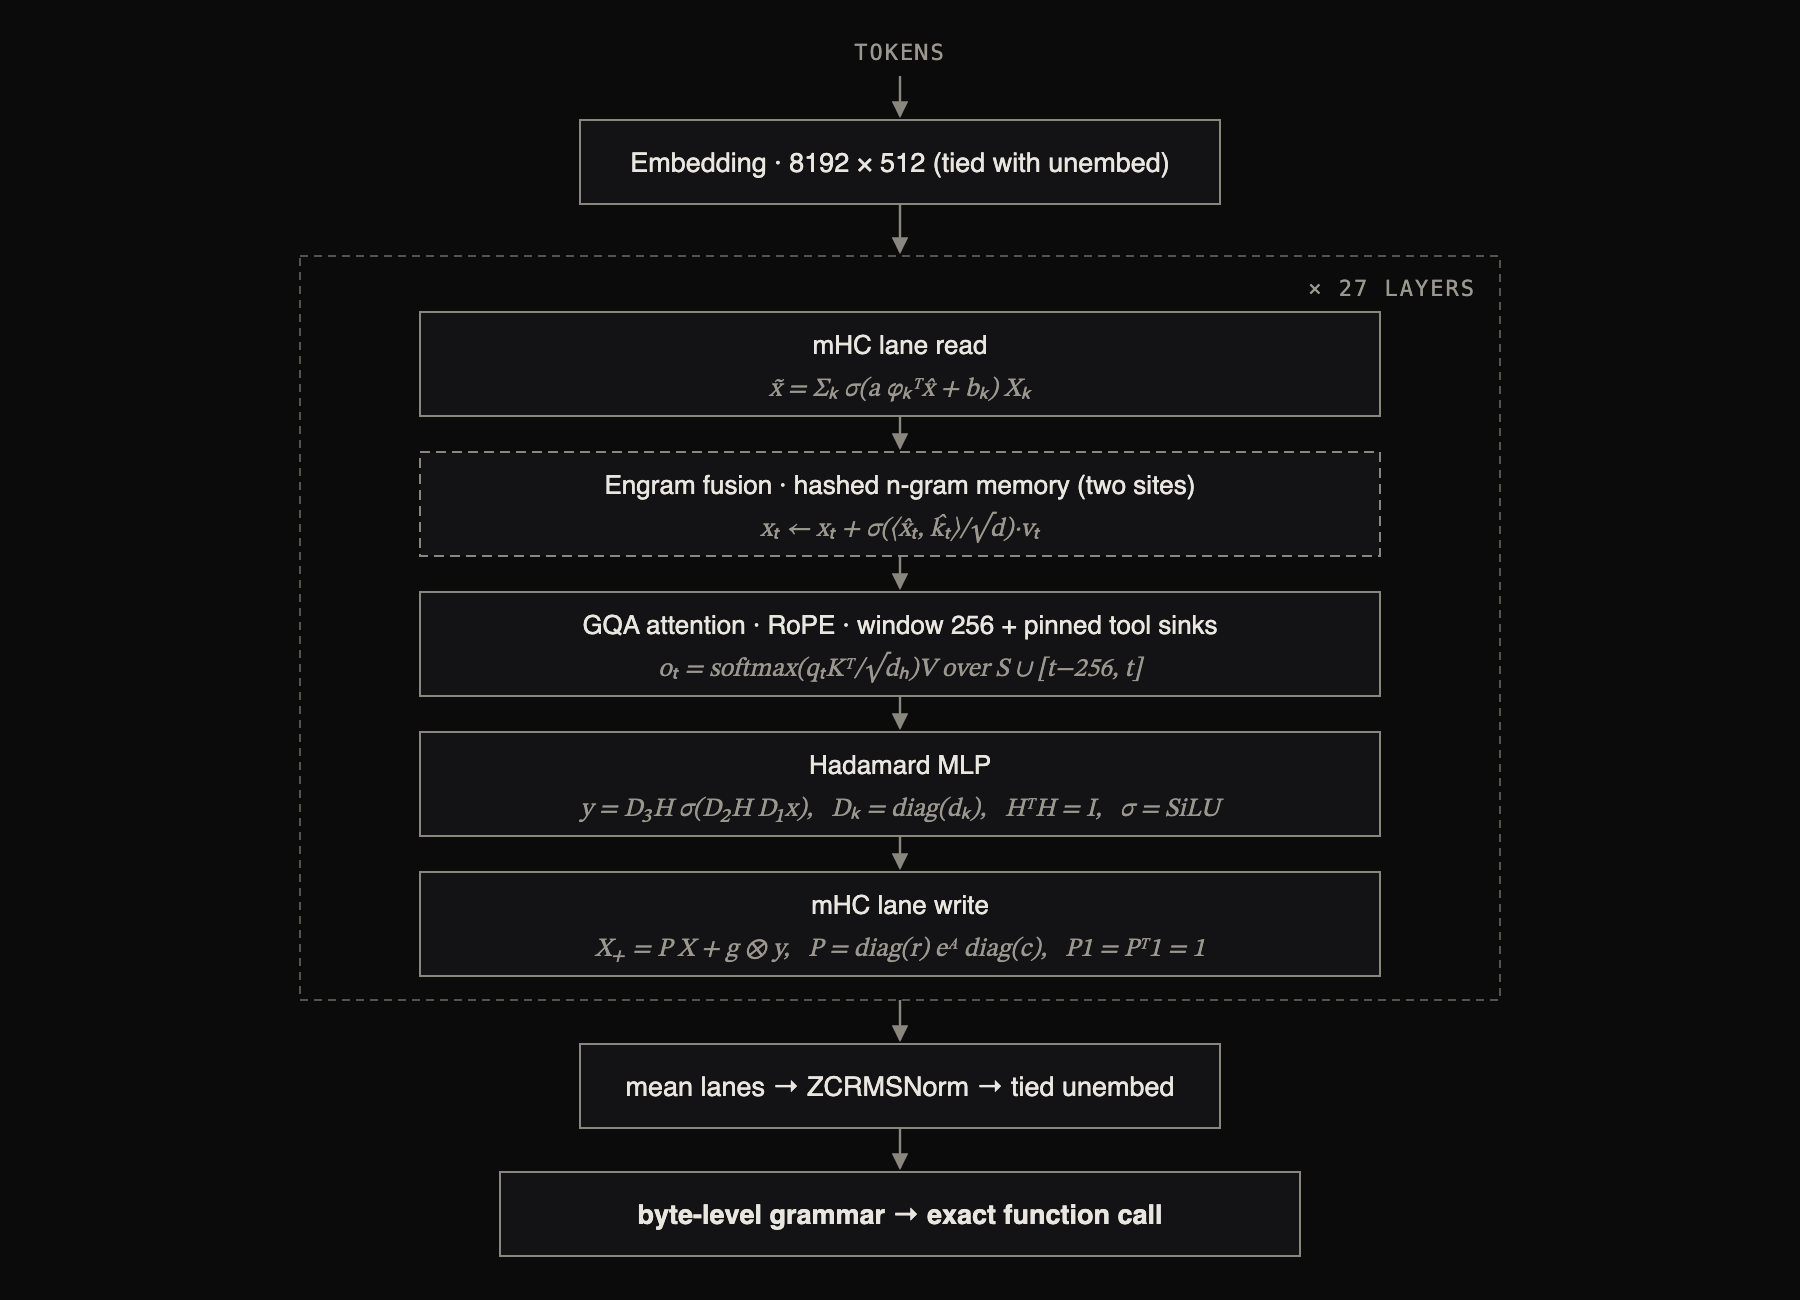
架构上它是 Simple Attention Network:一套致密小模型配方,用 Hadamard MLP 取代 FFN,配合 GQA 注意力、engram 键值记忆和多车道超连接,设计与消融见论文 arXiv:2607.18363。设计细节不如它换来的约束重要:内存有上界、输出受语法限制、每条响应带校准置信度。
为什么现在变热
- 趋势窗口内 661 星、2026-08-15 排名第 8——对一个模型发布(而非应用或框架)来说拉动罕见地强。
- 14MB 二进制、约 28MB 会话内存是可以亲手复测的具体数字,而不是语焉不详的 GPU 小时数。
- 由你的 schema 编译出的字节级语法约束每个生成 token,工具调用返回的 JSON 与声明形状一致。
- 每条响应都带一个由学习头输出的校准置信度——设阈值,高则执行,低则上报。
- 内置检索头每轮只渲染工具目录中前 5 个工具,语法也随之收窄到该子集。
- 内存天然有界:256 token 滑动窗口加工具 token 固定为 KV sink,会话无论多长都贴近 28MB。
解决什么问题
- 能塞进手机和可穿戴的工具调用模型很少,多数要几百 MB 或依赖服务器往返。
- 分发模型通常意味着随应用附带并版本化独立的权重文件。
- 小模型上长对话会因 KV cache 增长而突破内存预算。
- 没有输出约束时,小模型会生成畸形 JSON 或编造工具参数。
- 自主执行需要'何时上报'的信号,裸 logits 给不了。
- 庞大的工具目录会压垮极小的上下文窗口。
工作原理
- pip install cactus-needle 安装(pyproject.toml 要求 Python >= 3.9);首次运行从 Hugging Face 拉取一次引擎并缓存。
- 用 @needle.tool 装饰函数来描述工具:函数签名给出参数类型,docstring 即工具描述。
- 构造 needle.Needle(tools=[...]) 并调用 agent.run(query):模型选调用、Needle 执行你的函数、把结果回喂,最终响应把已执行结果附在 results 下返回。
- 结构化抽取:把 Pydantic 模型传给 needle.extract(),拿回类型化对象——README 用 vendor、total、due_date 三字段的 Invoice 演示。
- 解码时,由你的 schema 编译的字节级语法约束每个 token;检索头把语法收窄到当轮前 5 个工具。
- 置信度来自每个响应上的学习校准头,高置信走自动执行,低置信转人工或更大模型。
- 同一个包还覆盖 LoRA 微调与导出,对应 pyproject.toml 里 'inference, LoRA finetuning, and build' 的定位。
产品演示与界面预览
架构解读:14MB 里装了什么
Needle 2 是 Simple Attention Network:用 Hadamard MLP 替代常规 FFN、GQA 注意力、engram 键值记忆,层间用多车道超连接,设计与消融链接到 arXiv:2607.18363。每个块自带更新规则:H 是固定正交的 Walsh-Hadamard 变换,以 n log n 时间施加、无需读取权重;(k, v) 行取自哈希 n-gram 表;路由 logits 经 Sinkhorn 迭代归一成双随机矩阵 P;a、b、g 与 σ 门是可学习且依赖输入的。注意力与 MLP 残差都做三明治归一化并带门,engram 位点在两层触发。
真正干活的是两个机制。内存靠 256 token 滑动窗口加工具固定为 KV sink 保持有界,所以无论对话多长,会话都贴近 28MB。输出靠'由声明 schema 编译的字节级语法'约束解码——文本进、JSON 出——检索头每轮只渲染前 5 个工具,语法也随之限定在该子集。Cactus Quants 的 CQ2-bit 量化把 45M 参数压进 14MB 二进制。
置信度门是学习到的校准头而非启发式:每条响应带一个可设阈值的分数。这个数字就是'模型在猜'和'设备在决策'的分界。
上手路径:一个下午跑通 Quickstart
- pip install cactus-needle——包名与 2.0.0 版本来自 pyproject.toml,要求 Python >= 3.9。
- 首跑从 Hugging Face 拉取一次推理引擎并缓存,无需编译;隔离设备的离线部署见 README 指向的 doc/apis.md。
- README 的最小工具回路:用 @needle.tool 装饰 get_weather(city: str),构造 needle.Needle(tools=[get_weather]),调用 agent.run("what's it like in Lagos right now?"),读 results 键——示例返回 [{'city': 'Lagos', 'temp_c': 27, 'sky': 'clear'}]。
- 抽取路径:定义含 vendor、total、due_date 的 class Invoice(BaseModel),调用 needle.extract(text) 得到类型化对象。
- README 直言'描述好工具就是全部关键'——签名给类型、docstring 给描述,写描述要留足时间。
- pyproject.toml 的可选依赖:gpu 装 jax[cuda12];metal 固定 jax==0.4.38、jaxlib==0.4.38、jax-metal、flax==0.10.2、optax==0.2.4;test 附 pytest 与 pydantic。
维护解读:依赖前先核实什么
- 版本 2.0.0——全新主版本线,Python API 面可能变动。
- 值得给维护者发一封邮件的许可不一致:LICENSE 文件为 MIT(Copyright (c) 2026 Cactus Compute),而 pyproject.toml 声明 license = { text = "Apache-2.0" }。两者都宽松,但应先澄清再定。
- 依赖链偏重 JAX:huggingface_hub、numpy、jax、jaxlib、flax>=0.10.2、optax、sentencepiece;metal 扩展精确锁版本(jax==0.4.38),说明与特定 JAX 版本强耦合。
- 权重与引擎首跑取自 Hugging Face(Cactus-Compute/needle2);隔离安装的落地依赖 doc/apis.md,而该文档不在本次源包内。
- 测试存在——pyproject.toml 设 testpaths 为 tests,并定义 slow 标记用于端到端 JAX 构建/微调测试——但源包中没有 CI 配置、issue 历史或变更日志。
- 与 FunctionGemma 270M、LFM2.5 230M、Apple FM 的对比为厂商自报;先在自己的工具集上复现再下结论。
集成面:你的代码会碰到什么
- Python API:@needle.tool 装饰器、带工具列表的 Needle 类、返回 results 的 run() 工具调用回路,以及接受 Pydantic 模型返回类型化对象的 extract()。
- 自带 CLI:pyproject.toml 注册控制台脚本 needle = needle.cli:main。
- 随包资产:needle.model 携带 *.model 与 *.vocab;needle.playground 携带 index.html、app.js、style.css——内置浏览器 playground 目录。
- 运行足迹:单个 14MB 引擎二进制、会话约 28MB 内存、就绪后推理不联网、256 token 滑动窗口。
谁适合关注
适合关注
- 内存预算对得上约 28MB 会话的端上原型——手机、可穿戴、智能家居中枢、机器人。
- 需要按声明 schema 受限的工具调用、而非自由文本的产品。
- 边缘或隔离部署:一次性拉取、引擎缓存、推理不联网。
- 把托管 LLM 账单视作替代方案的高频结构化抽取 Python 服务。
- 需要置信度分数在自动执行与人工上报之间做路由的构建者。
可以先跳过
- 开放式生成、长文写作或通用聊天——模型为工具调用与抽取而调。
- 现在就要单一明确许可的产品;先解决 MIT 与 Apache-2.0 的不一致。
- 每轮前 5 的检索上限会饿死模型真正需要的工具的任务。
- 非 Python 运行时——本仓库是 Python 包,源包未显示其他绑定。
- 需要 f16 精度与更大余量、不愿接受 2-bit 折衷的场景。
风险与注意事项
宽松许可、确实够小、Python 面真实可用,但处于 2.0.0、出自单一厂商,许可字段不一致、JAX 依赖锁版本、基准为自报。
- LICENSE 写 MIT,pyproject.toml 写 Apache-2.0——都宽松,但法务评审前需澄清。
- 2.0.0 属全新主版本线,预期 API 会变。
- metal 扩展锁死 jax==0.4.38、jaxlib==0.4.38、flax==0.10.2、optax==0.2.4,与特定版本强耦合。
- 权重与引擎首跑取自 Hugging Face;源包未提供签名或溯源细节。
- 与 FunctionGemma 270M、LFM2.5 230M、Apple FM 的基准全部出自厂商自己的 README。
- README 称推理在一次性引擎拉取之后不再联网——对不该外联的设备是加分项。
- 解码受由你的 schema 编译的字节级语法约束,从根本上限制模型能吐出的 token。
- 自包含 14MB 二进制意味着没有独立权重文件可被篡改或错配——只需哈希并固定一个工件。
- 隔离部署前先读 doc/apis.md;源包未覆盖工件校验或安全策略。
- 工具执行跑的仍是你的 Python:把模型选出的参数当作带副作用工具的不可信输入对待。
替代方案比较
| 方案 | 适用场景 | 代价 |
|---|---|---|
FunctionGemma 270M | 需要更大容量的函数调用模型、且能承受 f16 权重 | 开放权重;内存占用更大 |
LFM2.5 230M | 移动级端上推理,装得下更大的小模型 | 开放权重;f16 体积至少是 Needle 的 5 倍 |
Apple FM | 在 Apple 平台体系内发布、沿用其模型家族 | 经 Apple 渠道分发 |
llama.cpp + GGUF 小模型 | 要的是本地通用生成与广泛运行时支持,而非 schema 受限的工具调用 | 免费、MIT 许可;模型自备并自行量化 |
这个趋势说明了什么
真正会调工具的可穿戴
约 28MB 的会话内存适配装不下 230M f16 模型的设备;把设备自身函数声明为工具,语法保证每次调用合法。
把引擎移植到目标设备,定义 5-10 个真实工具,实测调用准确率与峰值内存。
无云账单的边缘抽取
extract() 配 Pydantic 把非结构化文本就地转成类型化对象;14MB 二进制让按单元分发变得简单。
用几百份真实文档跑抽取,按字段级准确率对比现有管线。
置信度门控自动化
校准置信度头为每条响应给出一个可设阈值的数字:高于执行、低于上报。
回放历史请求,扫描阈值,画出上报率-错误率曲线后再接入真实动作。
RepoDaily 判断
Needle 2 的主张罕见地具体——45M 参数、单个 14MB 二进制、约 28MB 会话内存、语法受限的 JSON、校准置信度——Python 包让这些主张一个下午就能验证。中等风险在成熟度而非设计:2.0.0 版本线、MIT 与 Apache-2.0 的许可不一致、JAX 锁版本、自报基准。若你的设备预算与内存上限匹配,先跑 Quickstart,再决定是否相信那张 frontier 图。