
核心问题: RAGFlow 的模板感知切分质量是否值得运维其多服务栈,而非组合更轻量的 RAG 库?
RepoDaily 采用评分
RepoDaily 将该项目的采用分评为 91/100(强):分数来自文章来源、安装路径、生产风险、差异化、许可证清晰度以及 AI/Agent 适配度。
包含 5 个来源、覆盖 3 类来源;如有 RepoDaily 独有模块,会进一步提高证据分。
检测到 5 个工作流步骤、5 个下一步动作,以及 4 个命令/安装信号。
趋势热度为 +473 stars;如内容中有 release、issue 或维护信号,会提高维护可信度。
采纳风险标记为 medium,并包含 5 条安全说明与 4 条跳过条件。
3 个机会视角、4 个替代方案,以及 4 个类型化模块支撑差异化判断。
文章中包含许可证来源或许可证表述。
文章正文和元数据中检测到 6 个 AI/Agent 相关信号。
项目概览
RAGFlow(v0.26.4)是由 infiniflow 开发的开源检索增强生成引擎。项目描述将其定位为融合深度文档理解与 Agent 能力的 LLM 上下文层。GitHub 元数据将主要语言标记为 Go,但 pyproject.toml 显示了超过 100 个固定版本的 Python 依赖,涵盖文档解析、向量嵌入、向量存储和 LLM 客户端库。
pyproject.toml 声明 Python 版本约束为 >=3.13,<3.14,go.mod 指定 Go 1.26.4。这一双运行时架构意味着 Go 层(根据 go.mod 使用 Gin、GORM、Redis 和 NATS 构建)负责 API 服务和编排,而 Python 层处理文档摄入、嵌入生成和 LLM 交互。pyproject.toml 的依赖列表包含 Anthropic(0.76.0)、Cohere(5.6.2)、Mistral、Groq、DashScope(阿里通义千问,1.25.11)、Qianfan(百度,0.4.6)、Ollama 和 Google GenAI 的客户端,使 RAGFlow 开箱即兼容主流模型提供商。
RAGFlow 还通过 MCP 协议(mcp>=1.28.1)、browser-use(>=0.11.1)和 crawl4ai(>=0.9.2)集成了 Agent 能力,将其定位从静态文档检索扩展到 Agent 驱动的研究。pyproject.toml 中 graspologic 依赖被固定到 Gitee 上的特定提交,暗示了用于 GraphRAG 的知识图谱增强检索功能。README 展示了项目在 GitHub Octoverse 和 Trendshift 上的认可,并在 ragflow.io/docs/dev/ 维护文档,在 issue 12241 维护公开路线图。
安全方面需要关注。SECURITY.md 记录了 api/utils/__init__.py 第 215 行 restricted_loads 函数中的代码执行漏洞——numpy.f2py.diagnose.run_command 函数绕过了 pickle 反序列化的模块白名单。此外,SECURITY.md 的支持版本表仅列出 <=0.7.0 接收安全更新,相对于当前 0.26.4 版本明显过时。
为什么现在变热
- README 中展示了 GitHub Octoverse 认可和 Trendshift 徽章
- 2026-08-14 获得 473 个周期星标,趋势排名第 11 位,表明持续的开发者关注
- 当前版本 v0.26.4,Docker 镜像(infiniflow/ragflow)活跃,公开路线图位于 issue 12241
- Go 1.26.4 与 Python 3.13 双运行时架构,表明现代且积极维护的代码库
- 覆盖 DeepSeek、OpenAI 兼容端点、Ollama、Anthropic、Cohere、Mistral、Groq、阿里通义千问和百度文心一言等模型提供商
解决什么问题
- 朴素文本切分会拆分表格、表单和多栏布局,产生丢失关键上下文的检索片段
- 检索上下文浅薄或文档基础不足时 LLM 回答出现幻觉
- 专有 RAG 平台导致供应商锁定,限制模型选择并阻碍私有化部署
- 团队需要组合文档解析、向量索引、Agent 编排和多提供商 LLM 访问时工具碎片化
- 难以追踪每个回答来自哪个源文档段落,削弱检索增强答案的可信度
工作原理
- 文档通过 Python 管道摄入,使用 pdfplumber(0.11.10)、python-docx、python-pptx 和 opencv-python(4.10.0.84)解析 PDF、Office 文档和图片等复杂格式
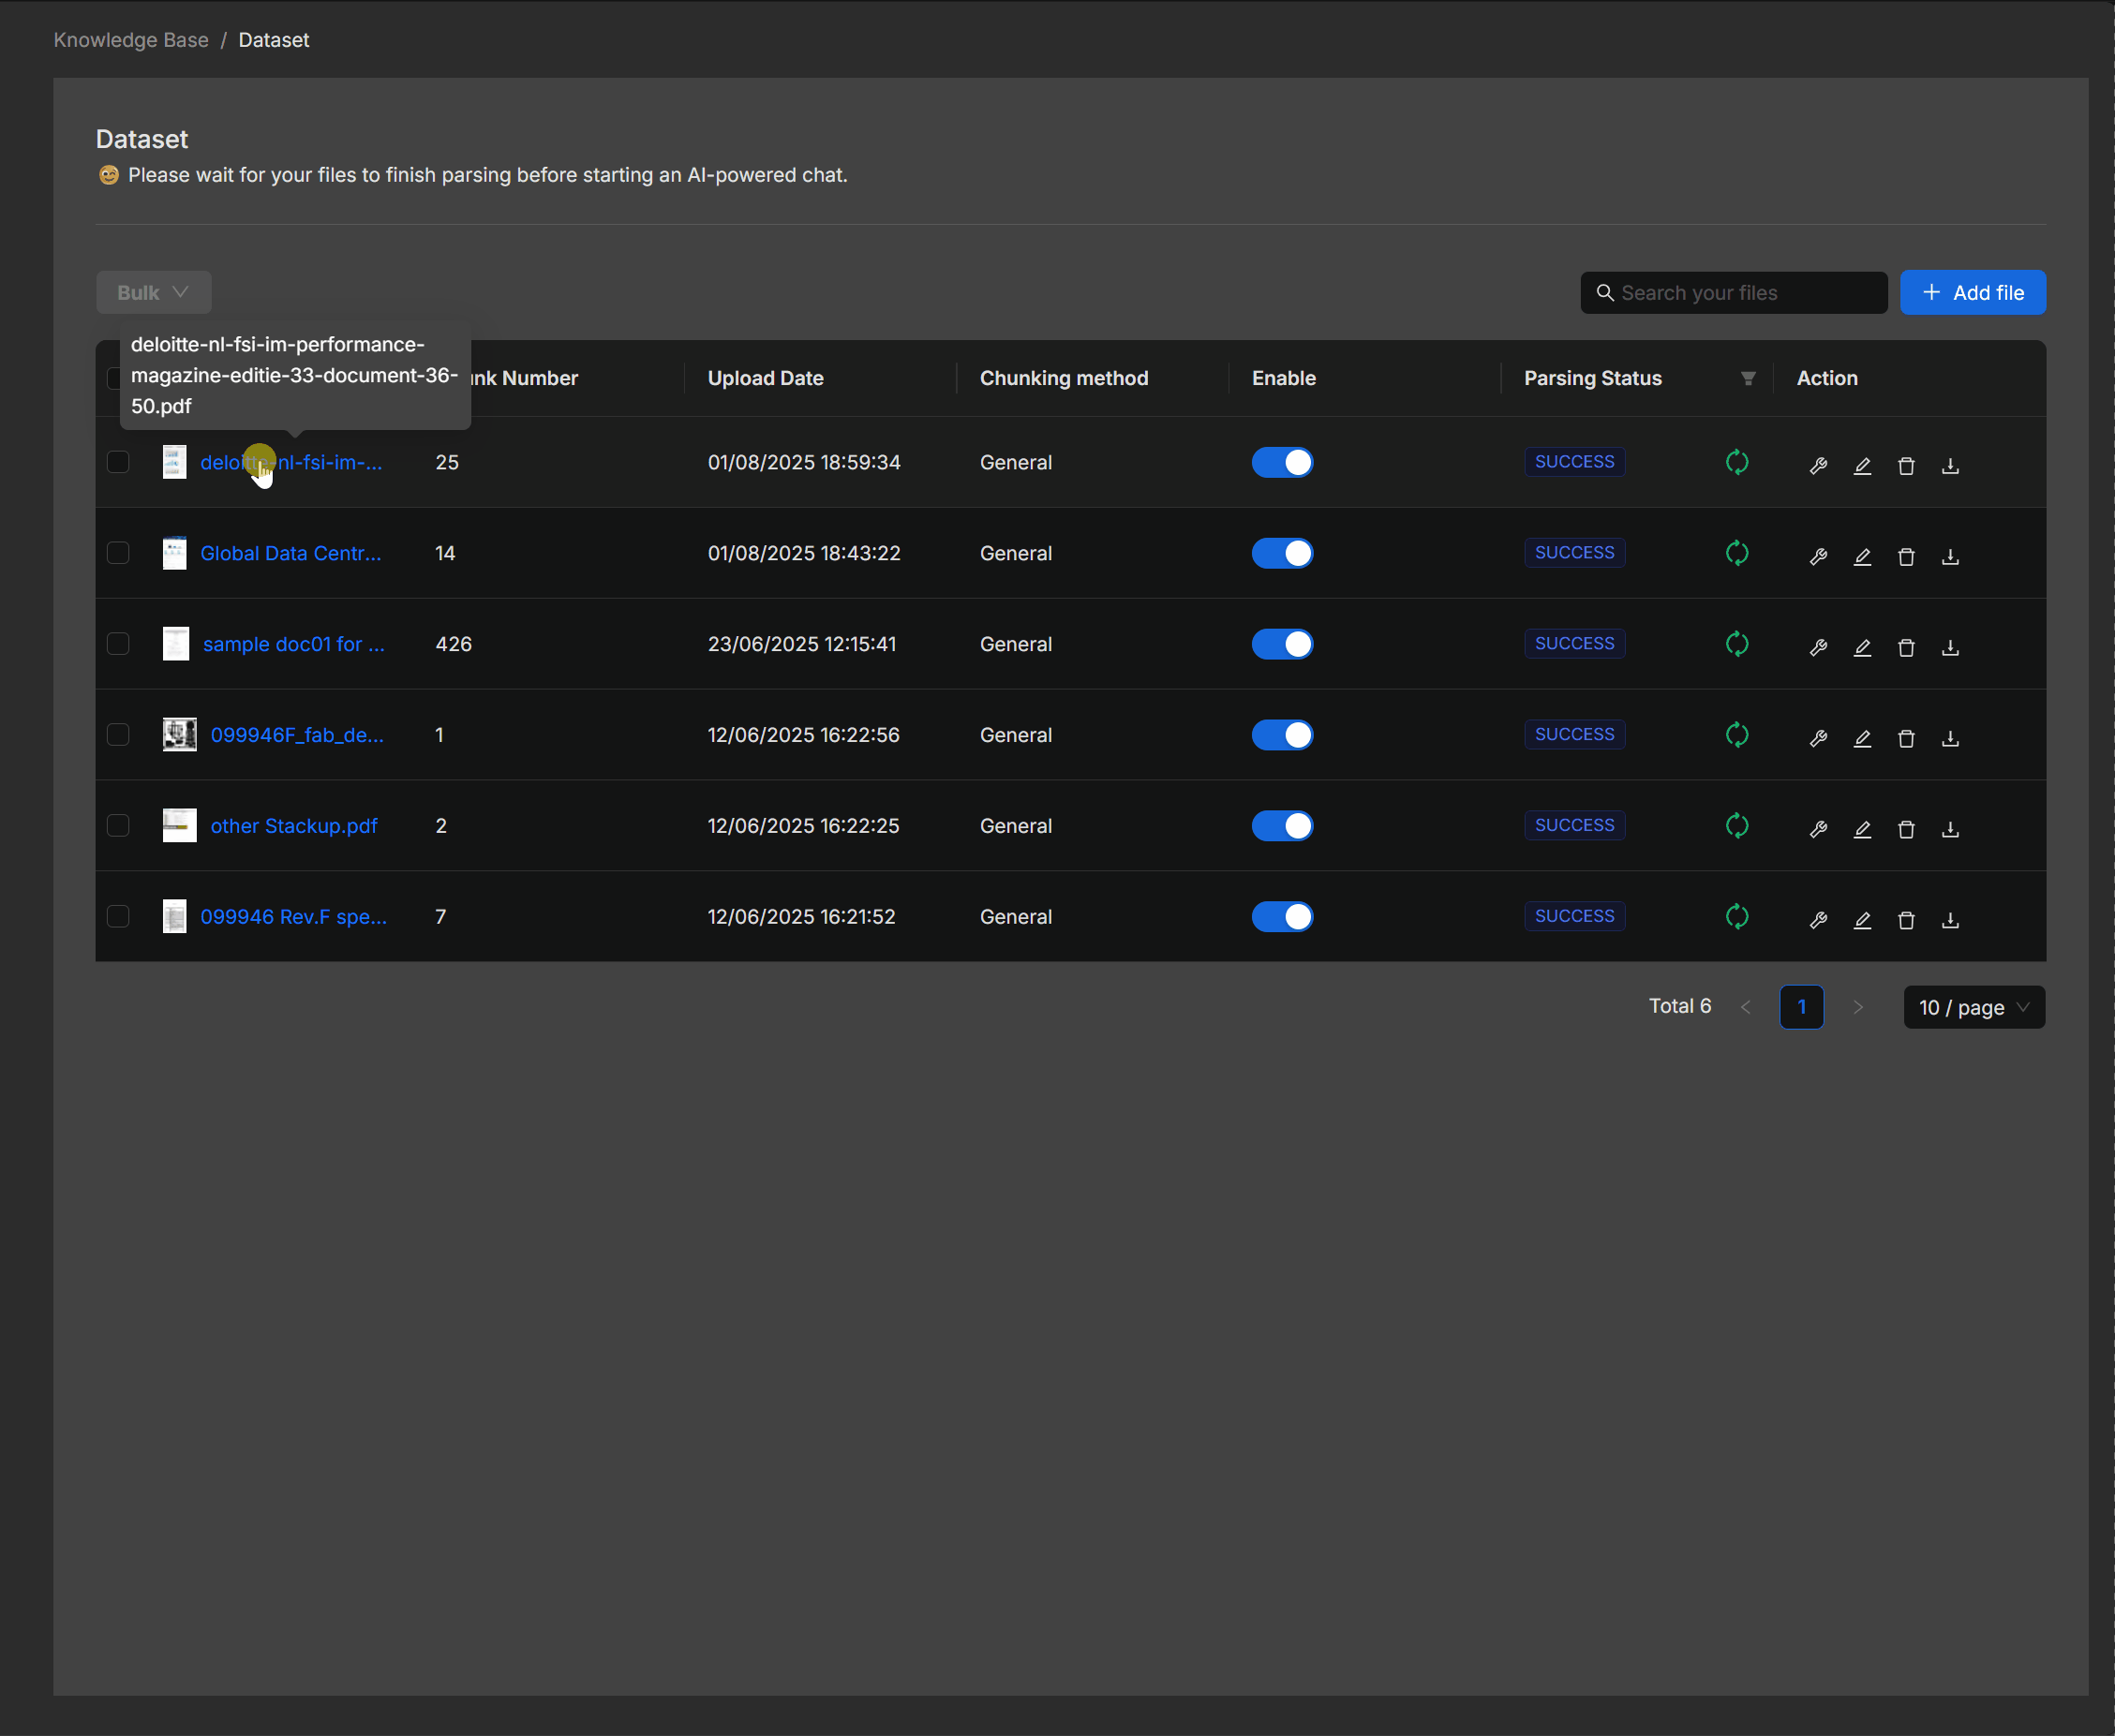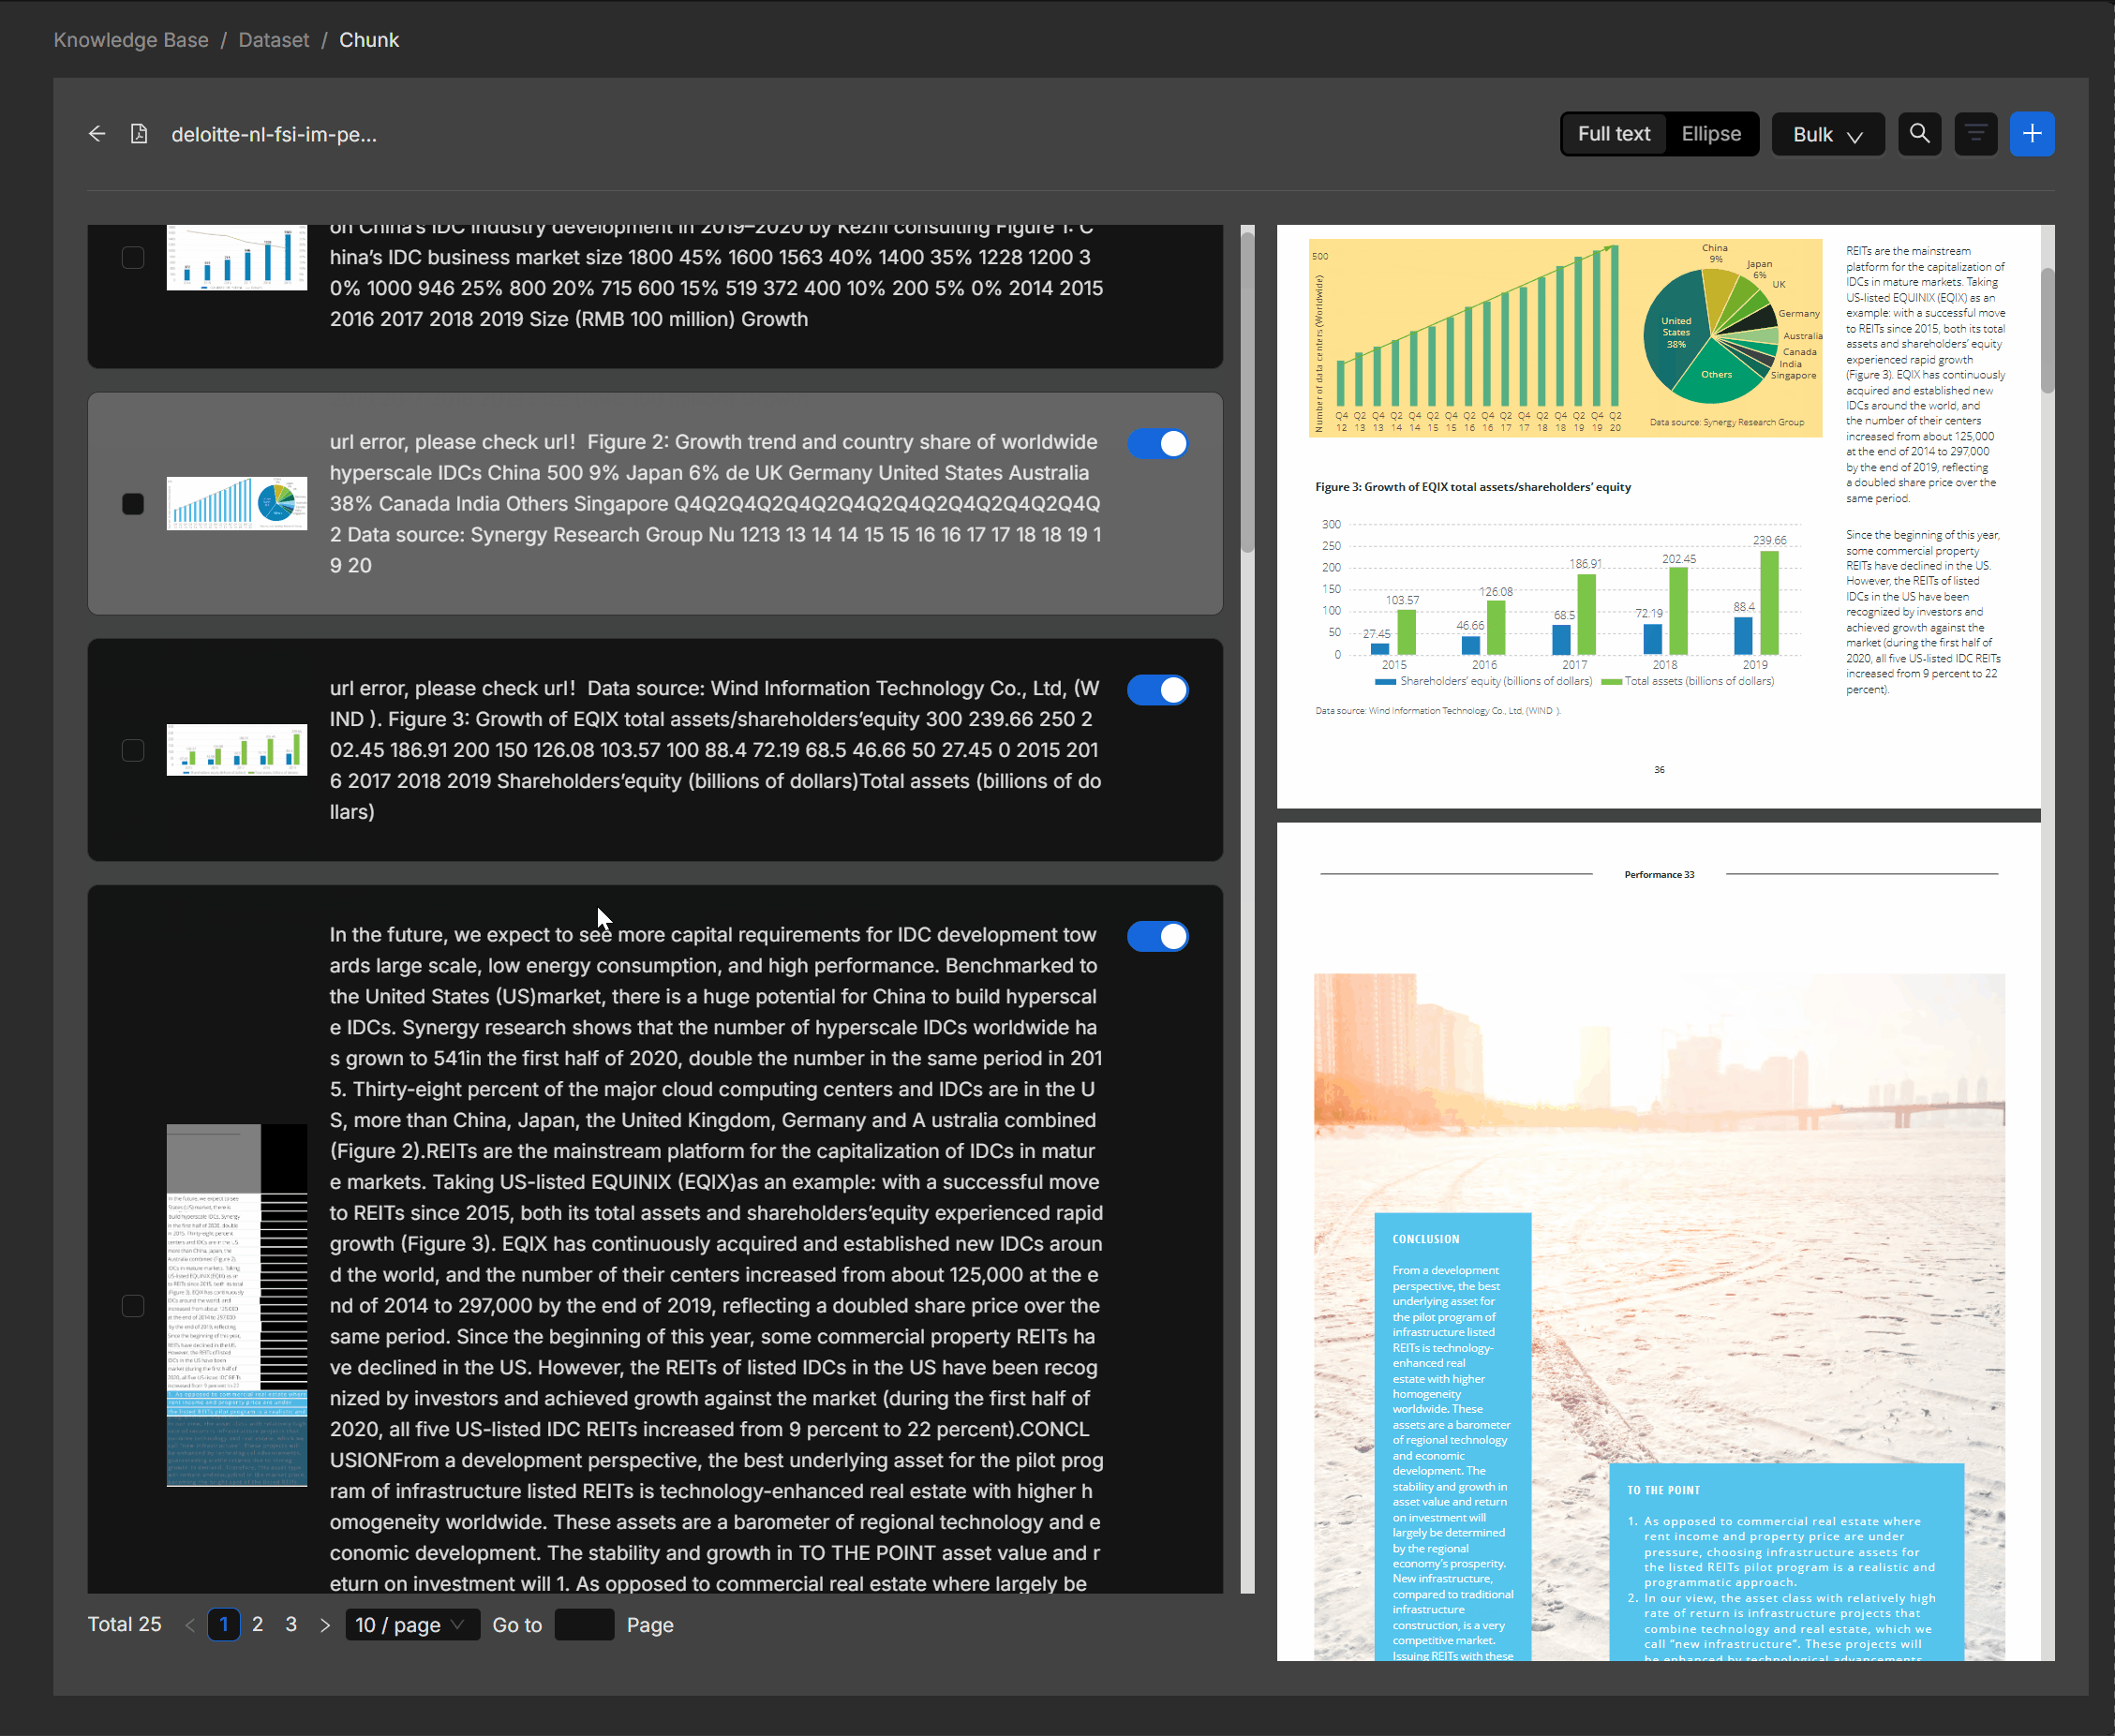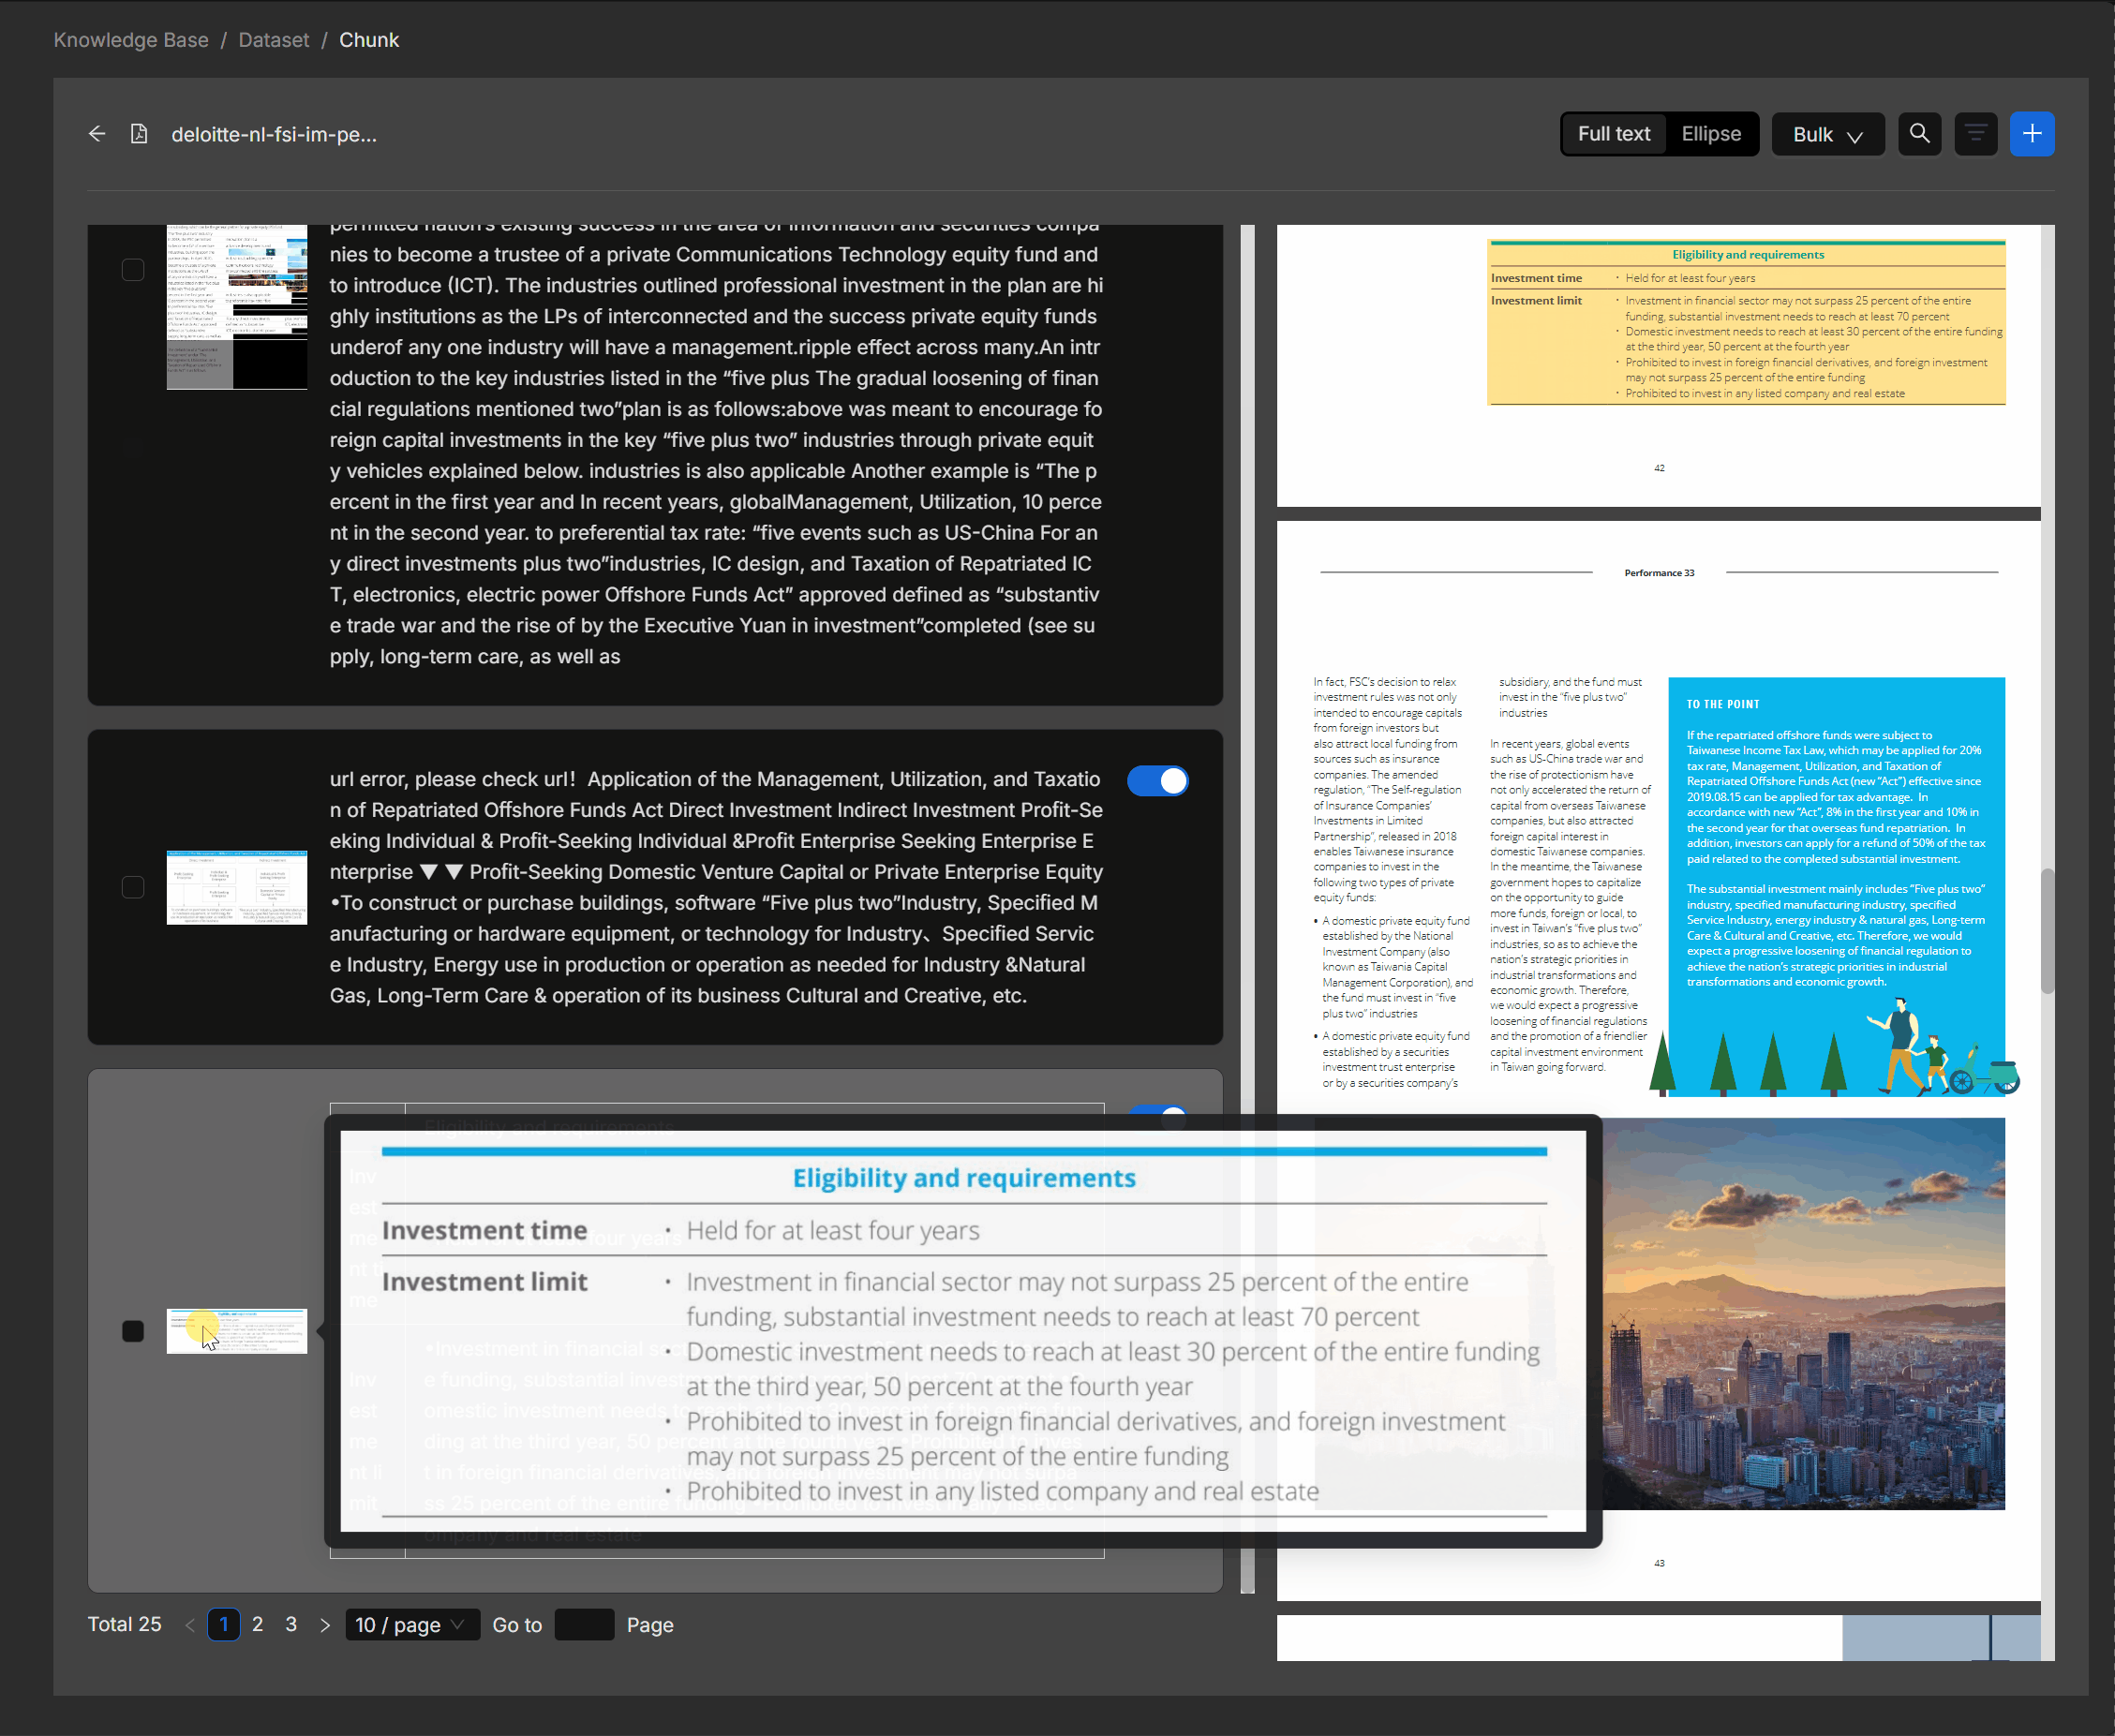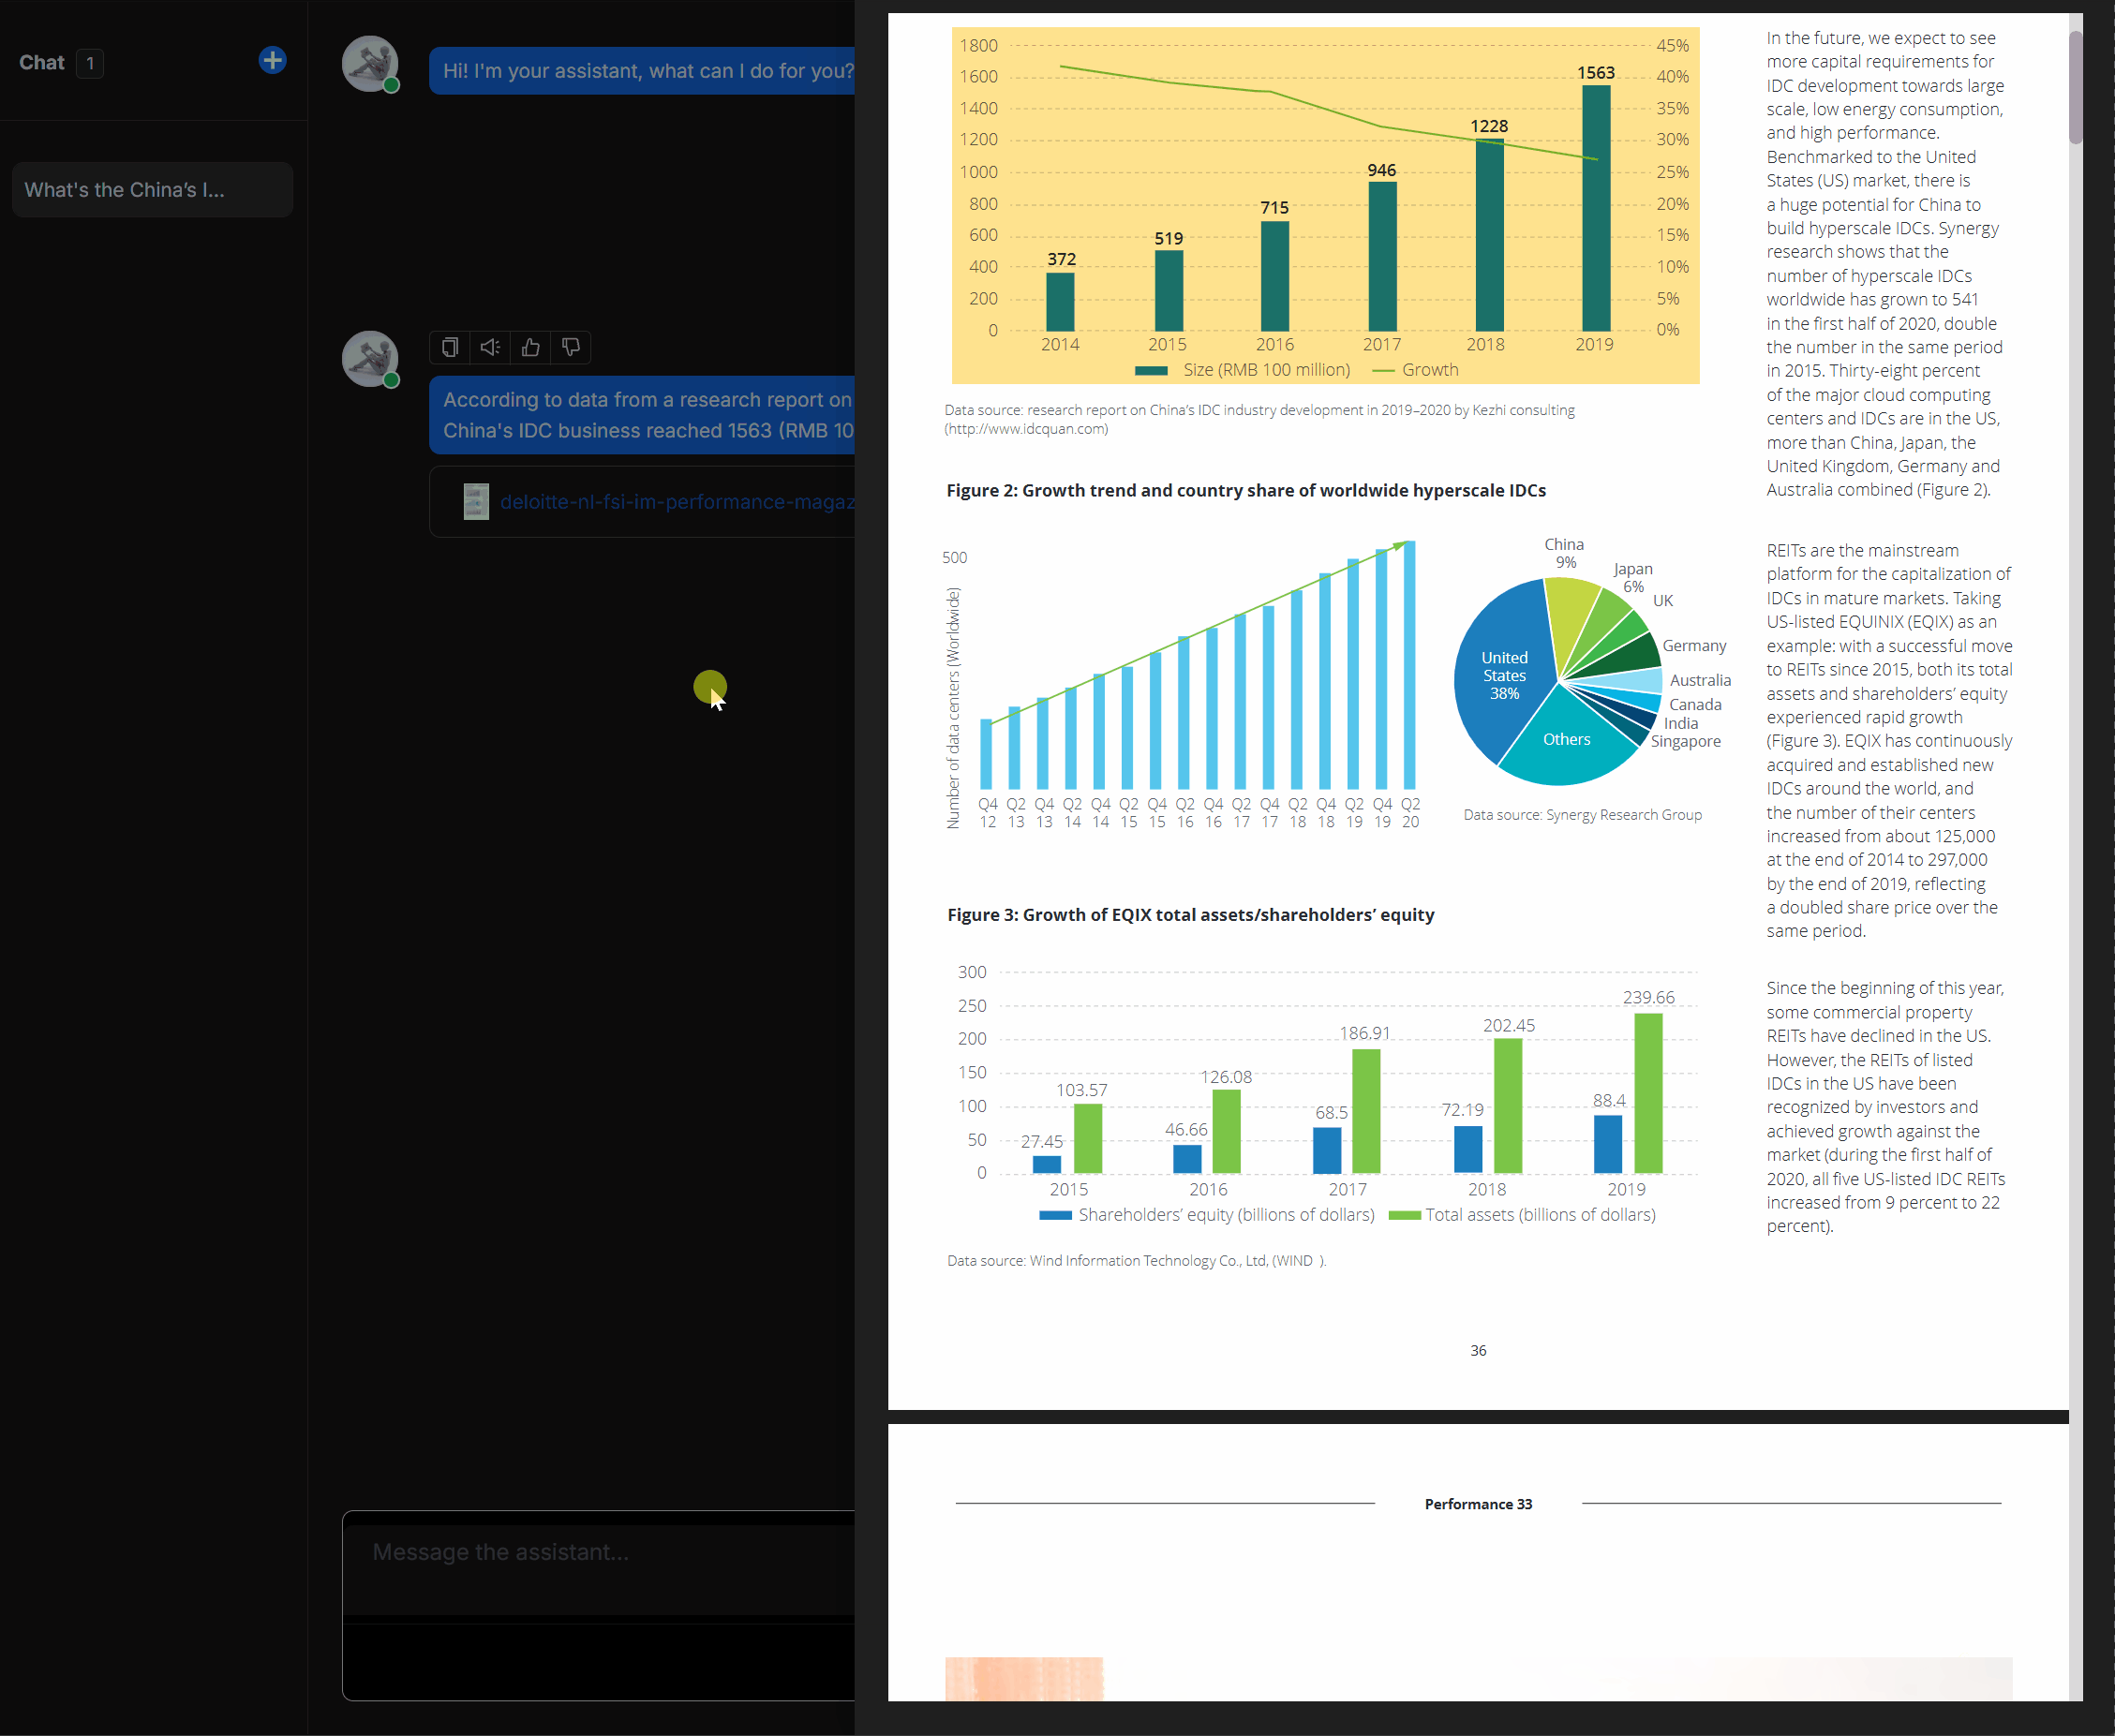
- 解析内容采用模板感知切分策略而非固定大小分割,README 中的切分演示图展示了这一过程
- 切分块通过 ONNX Runtime(1.23.2,根据平台选择 GPU 或 CPU 版本)或提供商嵌入 API 生成向量,然后索引到 Elasticsearch(elasticsearch-dsl 8.12.0)、OpenSearch(2.7.1)或 InfiniFlow 自研 Infinity 向量数据库(infinity-sdk 0.7.3)
- Agent 编排层使用 MCP(>=1.28.1)、browser-use 和 crawl4ai 将检索扩展到实时网页访问和工具调用
- 查询时,Go API 层(基于 Gin)将请求路由经过检索、排序和 LLM 生成,返回带有指向具体文档块引用的答案
产品演示与界面预览
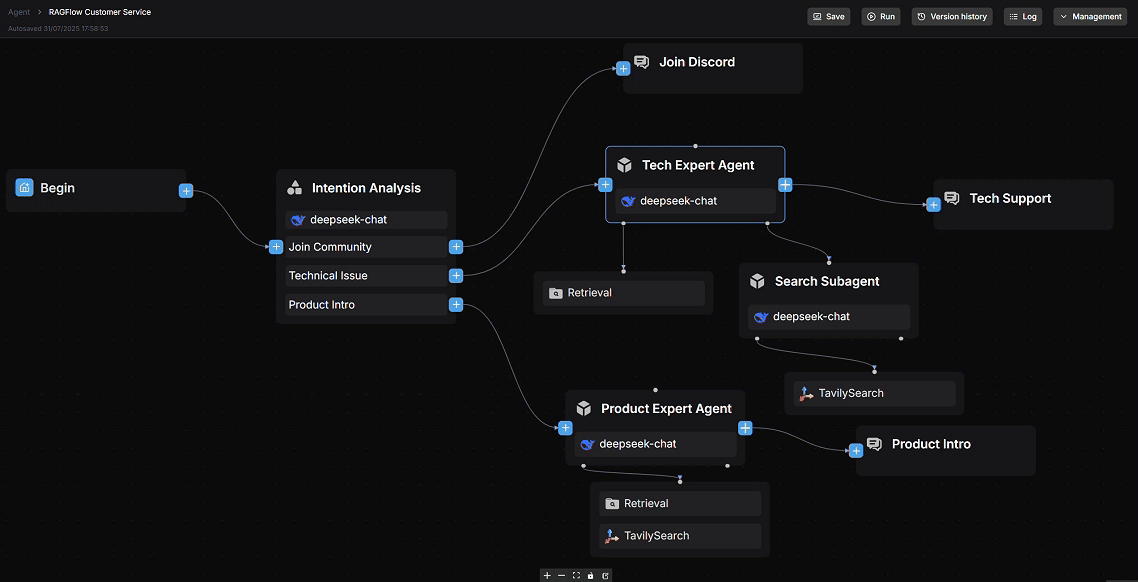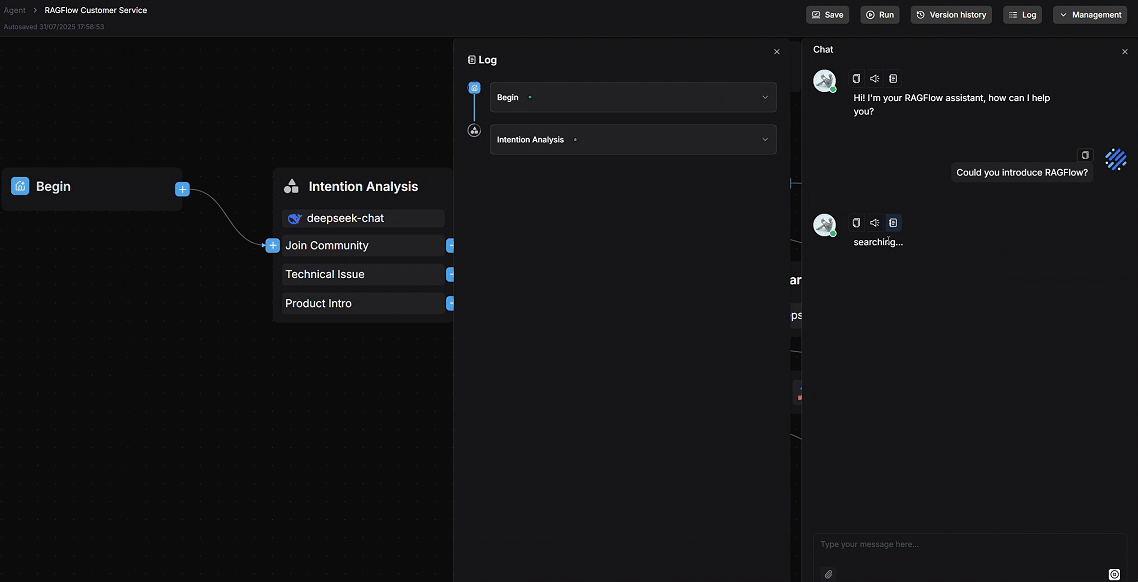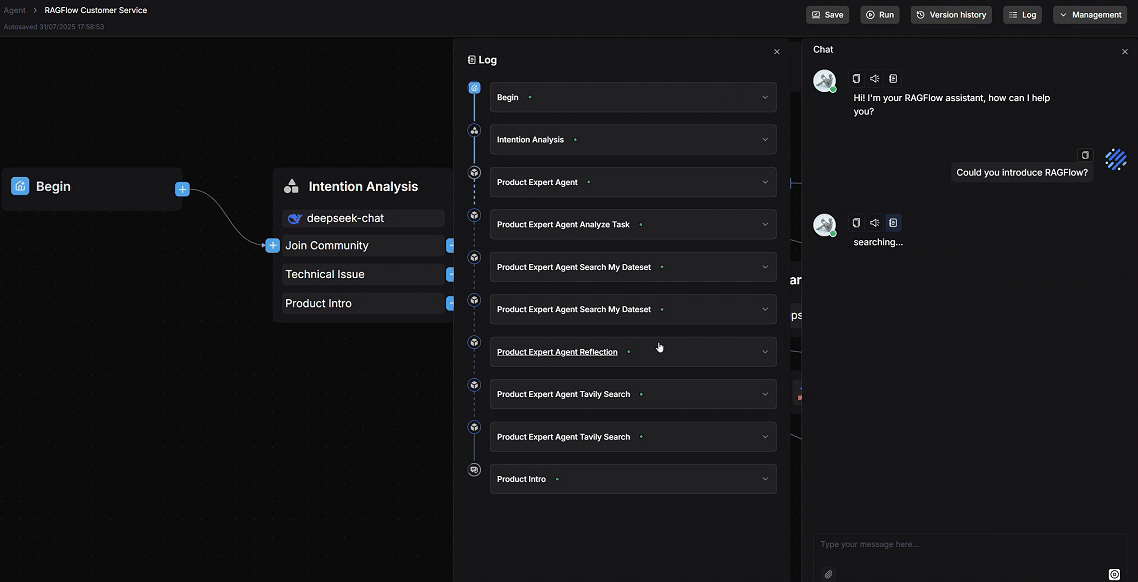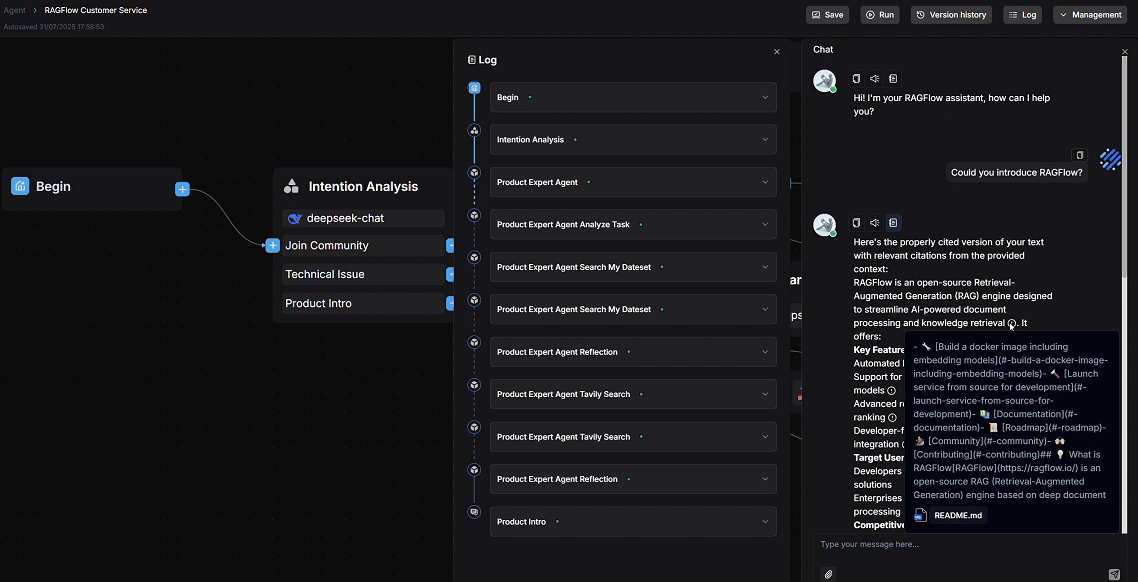
架构解读:Go 网关与 Python 处理核心
go.mod 声明模块 'ragflow',Go 版本 1.26.4,引入 Gin(v1.12.0)做 HTTP 路由,GORM(v1.25.7)配合 MySQL 和 SQLite 驱动做关系存储,Redis(go-redis v9)做缓存和会话状态,NATS(v2.14.3 服务端,v1.52.0 客户端)做内部消息传递。OpenTelemetry(v1.44.0)用于链路追踪,AWS SDK v2 和 Google Cloud Storage 客户端用于对象存储。
pyproject.toml 声明 ragflow v0.26.4,要求 Python >=3.13,<3.14。值得关注的固定依赖包括 anthropic==0.76.0、cohere==5.6.2、dashscope==1.25.11、qianfan==0.4.6、ollama>=0.5.0 和 google-genai>=1.41.0。graspologic 依赖固定到 Gitee 上的特定提交(infiniflow 镜像),表明为 GraphRAG 图构建使用了定制分支。infinity-sdk(0.7.3)和 infinity-emb(>=0.0.66)的引入将 RAGFlow 与 InfiniFlow 自研的向量数据库和嵌入服务绑定。
集成面:模型提供商、存储后端和 Agent 工具
- 模型提供商:Anthropic、Cohere、Mistral、Groq、阿里 DashScope(通义千问)、百度 Qianfan、Google GenAI、Ollama 和 OpenAI 兼容 API——均作为固定或限定版本依赖出现在 pyproject.toml 中
- 向量存储:Elasticsearch(elasticsearch-dsl 8.12.0)、OpenSearch(opensearch-py 2.7.1)和 InfiniFlow Infinity(infinity-sdk 0.7.3)
- 对象存储:MinIO(7.2.4)、AWS S3(boto3)、Google Cloud Storage、Azure Data Lake(12.16.0)、Dropbox 和 Box SDK
- Agent 工具:MCP 协议客户端(mcp>=1.28.1)、browser-use(>=0.11.1)用于 Web 自动化、crawl4ai(>=0.9.2)用于网页抓取、DuckDuckGo 搜索(>=7.2.0)
- 文档格式:PDF(pdfplumber 0.11.10、pypdf)、Word(python-docx)、PowerPoint(python-pptx)、Excel(python-calamine、Go 侧 excelize)、HTML(html-text、markdownify)和邮件(extract-msg)
- 协作集成:Discord(discord-py 2.3.2,为 Python 3.13 使用 audioop-lts 回退)、Jira(3.10.5)、Atlassian API(4.0.7)、钉钉和飞书 SDK
部署说明:Docker 优先,运行时要求严格
README 链接到 Docker Hub 上的 infiniflow/ragflow 镜像,当前标签为 v0.26.4。README 中的 Docker 徽章引用了 docker pull infiniflow/ragflow:v0.26.4。从源码部署的团队需准备恰好 Python 3.13(约束为 >=3.13,<3.14)和 Go 1.26.4——均为 2026 年中的最新运行时版本。
pyproject.toml 记录了一个 Python 3.13 兼容性问题:discord-py 2.3.2 导入已移除的 audioop 模块,需要 audioop-lts(>=0.2.1)回退包。Werkzeug 版本也受到约束以避免 multipart 解析缺陷。这些固定变通方案表明团队积极维护前沿运行时兼容性,但采用 RAGFlow 的团队应预期匹配这些精确版本。
维护风险:依赖广度和安全策略缺口
- pyproject.toml 列出超过 100 个直接依赖——这一面积增加了传递性漏洞暴露和升级协调成本
- SECURITY.md 记录了 restricted_loads(api/utils/__init__.py 第 215 行)中的代码执行漏洞,可通过 numpy.f2py.diagnose.run_command 利用,并提供了概念验证
- SECURITY.md 的支持版本表仅列出 <=0.7.0 为受支持版本,而当前发布版本为 0.26.4——该表似乎过时,对哪些版本接收补丁造成模糊
- graspologic 固定到 Gitee 特定提交(38e680cab72bc9fb68a7992c3bcc2d53b24e42fd)而非标签版本,影响可复现性和上游追踪
谁适合关注
适合关注
- 需要摄入含表格、表单或多栏布局的 PDF 团队——朴素切分会产生不可用的片段
- 需要私有化部署并选择 DeepSeek、Ollama 或通义千问等模型提供商的组织
- 需要在静态文档检索之外结合 GraphRAG 或 Agent 驱动研究的项目
- 具备 Docker、Elasticsearch 或 OpenSearch、对象存储运维能力并适应 Go+Python 双语言代码库的工程团队
可以先跳过
- 只需对纯文本做关键词搜索的简单 FAQ 聊天机器人
- 缺乏容器化经验或没有 Elasticsearch、Redis 和对象存储专用基础设施的团队
- 要求最小依赖树的项目——仅 Python 依赖就超过 100 个包
- 锁定 Python 3.11 或 3.12 的环境——RAGFlow 要求 Python >=3.13,<3.14
风险与注意事项
项目在 v0.26.4 积极维护并有公开路线图,但 Python 依赖面超过 100 个包,存在已记录的 pickle 反序列化漏洞,且 SECURITY.md 支持版本表已过时。
- SECURITY.md 记录了 restricted_loads 中通过 numpy.f2py.diagnose.run_command 的代码执行漏洞,附带可用的概念验证代码
- SECURITY.md 支持版本表仅标记 <=0.7.0 接收安全更新,对当前 0.26.4 版本的补丁覆盖造成不确定性
- Python 运行时固定在 >=3.13,<3.14 的窄窗口,限制了与现有环境的兼容性
- graspologic 来自 Gitee 特定提交而非 PyPI 发布,增加供应链审计难度
- Go+Python 双语言架构相比单语言方案使运行时和工具链管理负担加倍
- 根据 LICENSE 采用 Apache-2.0 协议,允许商业使用、修改和再分发
- SECURITY.md 披露 api/utils/__init__.py 第 215 行 restricted_loads 漏洞:numpy 模块导入绕过 pickle 白名单,可实现远程代码执行
- SECURITY.md 中的概念验证通过 numpy.f2py.diagnose.run_command 函数执行任意 shell 命令(whoami)
- SECURITY.md 支持版本表仅将 <=0.7.0 标记为接收安全更新,而当前发布版本为 0.26.4
- 依赖中包含 pycryptodomex(3.20.0)和 paramiko(>=3.5.1),在生产部署中应审计其传递性 CVE
替代方案比较
| 方案 | 适用场景 | 代价 |
|---|---|---|
LlamaIndex | 需要 Python 原生 RAG 框架,对索引策略有精细控制需求,并依赖大型插件生态时 | 免费,MIT 许可 |
Dify | 需要可视化管道构建器来组装 LLM 应用,内置 RAG 和 Agent 编排时 | 免费自托管,Apache-2.0;提供付费云版本 |
Haystack (deepset) | 需要生产级搜索管道,重视类型安全和多向量存储连接器时 | 免费,Apache-2.0 |
LangChain | 需要通用 LLM 应用框架,重视社区支持和丰富集成时 | 免费,MIT 许可 |
这个趋势说明了什么
基于精细切分的企业级文档智能
RAGFlow 的模板感知切分(README 切分演示中可见)瞄准了通用 RAG 库在财务报告和技术规格等结构化文档上失效的空白。
在 50 份复杂 PDF 上对比 RAGFlow 切分与固定大小切分,用保留的问题集衡量检索精度。
基于 MCP 集成的深度研究 Agent
mcp>=1.28.1 依赖和 browser-use 集成将 RAGFlow 定位于结合实时网页研究与文档检索的 Agent 工作流——topics 列表明确标注了 'deep-research' 场景。
构建原型 Agent 同时查询文档索引和通过 MCP 访问实时网页,然后在研究基准上评估答案质量。
多模型私有化部署
Ollama、DashScope、Qianfan 和 OpenAI 兼容端点均已接入,适合需要将不同查询类型路由到不同模型以优化成本或延迟的组织。
配置两个模型后端(一个通过 Ollama 本地,一个云端),在代表性负载上测量每 1,000 次查询的延迟和成本。
RepoDaily 判断
RAGFlow v0.26.4 是一个功能密集的 RAG 平台,以模板感知切分、基于 graspologic 定制分支的 GraphRAG 以及通过 MCP 的 Agent 编排为差异化优势。权衡在于沉重的依赖面(100+ Python 包,Go+Python 双运行时)、pickle 反序列化路径中已记录的代码执行漏洞,以及过时的安全策略版本表。将切分质量和多提供商灵活性置于运维简洁性之上的团队将在此获得最大价值。